Создал пустой .txt и сохранил его в UTF-8 кодировке. При чтении файла в массив байтов, через FileInputStream читается три байта [-17, -69, -65]. Что это за байты? И почему они считываются если файл пустой?
Даже когда в файле есть текст, читаются эти три байт, а потом байты текста.
Если сохранить файл с кодировкой по умолчанию ("ANSI"), он действительно пустой. Доп байтов нет.
Тогда второй вопрос. Как из него считать кириллицу или перекодировать в UTF-8?
![]()
![]()
Александр Гаевский (Alexandr Gaevskiy)
39 уровень
Кто сможет объяснить?
Обсуждается
Комментарии (11)
- популярные
- новые
- старые
Для того, чтобы оставить комментарий Вы должны авторизоваться
hidden #2322530
10 сентября 2020, 07:55
метод read() читает всё. даже служебные символы, которые ты не видишь. используй BufferedReader и readLine(), этот метод возвращает чистую строку без служебных символов.
0
Александр Гаевский (Alexandr Gaevskiy)
10 сентября 2020, 16:59
Всё равно ![]()
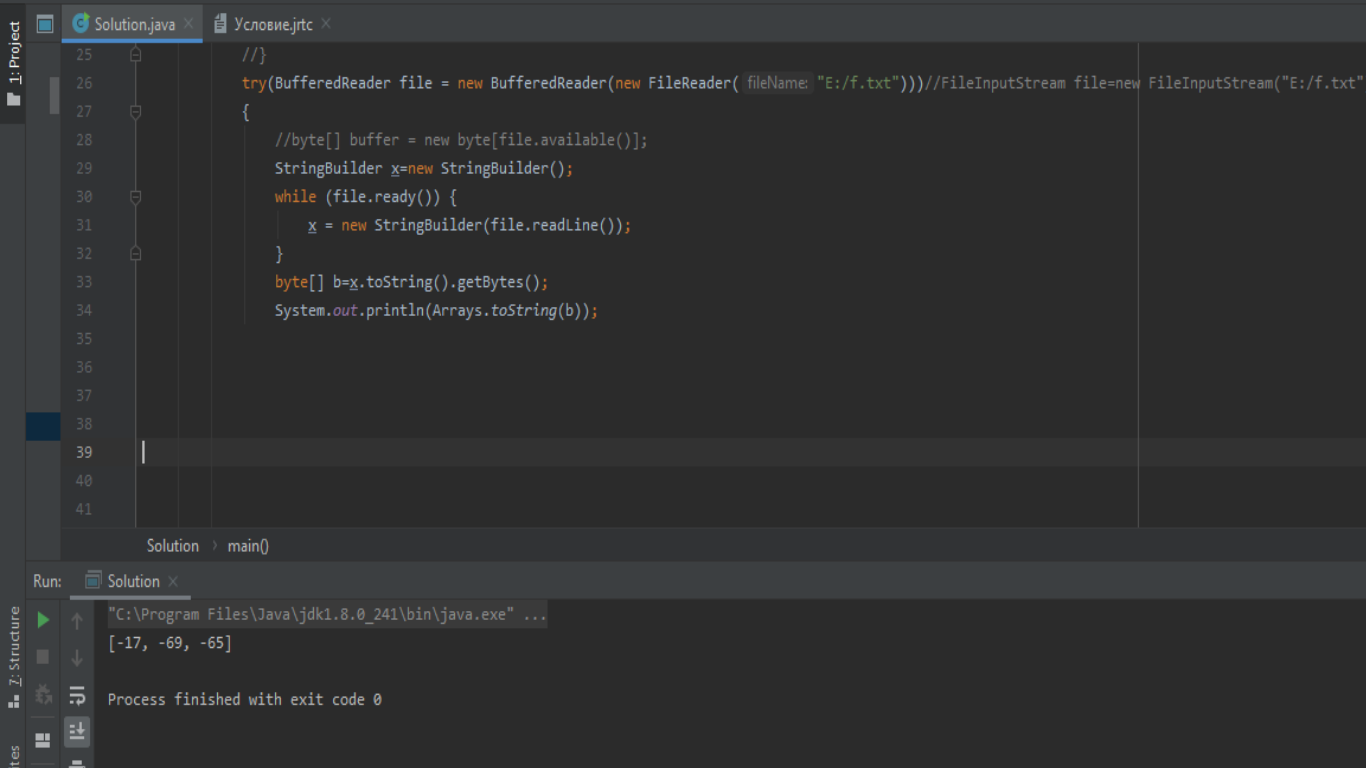
0
Александр Гаевский (Alexandr Gaevskiy)
10 сентября 2020, 17:06
Суть в том, что из-за этих трёх байтов я не могу сравнить два первых слова разделённых пробелом.
equals() считает их не равными, из-за этих трёх байтов
0
hidden #2322530
10 сентября 2020, 17:08
а зачем ты читаешь слова побайтно? ))) я тебе выше уже напилсал, используй readLine()
0
Александр Гаевский (Alexandr Gaevskiy)
10 сентября 2020, 17:30
Есть .txt в кодировке Utf-8. В нём два одинаковых слова разделённые пробелом "торт торт". Когда читаю файл построчно readLine() и делю строку на массив через split("\\s").
equals() шлёт меня нафиг и говорит что они не ровны.
0
Александр Гаевский (Alexandr Gaevskiy)
10 сентября 2020, 17:33
начал смотреть по байтам. эти три байта крепятся к первому слову. и хоть как читай они есть
0
hidden #2322530
10 сентября 2020, 17:37
создай файл в IDE прямо. его и считывай
0
Александр Гаевский (Alexandr Gaevskiy)
10 сентября 2020, 17:42
получилось обойти только когда собрал велосипед)))
try(FileInputStream file=new FileInputStream("E:/f.txt"))
{
byte[] buffer = new byte[file.available()];
file.read(buffer, 0, buffer.length);
byte[] cope=Arrays.copyOfRange(buffer,3,buffer.length);
String buf=new String(cope);
list.addAll(Arrays.asList(buf.split("\\s")));
0
Александр Гаевский (Alexandr Gaevskiy)
10 сентября 2020, 17:44
2 минуты назад
создай файл в IDE прямо. его и считывай
это понятно...
просто возник вопрос... почему же всё так сложно
0
hidden #2322530
10 сентября 2020, 17:57
несложно. просто не надо использовать read() там, где просят считать строку. read() считывает байты символов. а в зависимости от редактора, байты везде могут быть разными.
у меня был случай, помогал так же человек, у него вообще строка пропадала из-за Microsoft Office) так что я все примеры делают прямо IDE
0
ГоффMaster
9 сентября 2020, 23:48
https://ru.wikipedia.org/wiki/%D0%9C%D0%B0%D1%80%D0%BA%D0%B5%D1%80_%D0%BF%D0%BE%D1%81%D0%BB%D0%B5%D0%B4%D0%BE%D0%B2%D0%B0%D1%82%D0%B5%D0%BB%D1%8C%D0%BD%D0%BE%D1%81%D1%82%D0%B8_%D0%B1%D0%B0%D0%B9%D1%82%D0%BE%D0%B2
0