BufferedReader rd1 = new BufferedReader(new FileReader(fileName1));
BufferedReader rd2 = new BufferedReader(new FileReader(fileName2));Джал
28 уровень
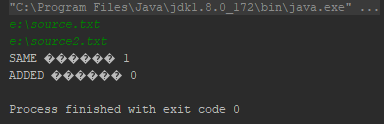
Почему нужно использовать именно FileReader?
Решен
Комментарии (6)
- популярные
- новые
- старые
Для того, чтобы оставить комментарий Вы должны авторизоваться
Ярослав Java Developer Master
13 июля 2018, 15:02
Недостаточно информации, чтобы правильно ответить. Вы не показали то, как вы используете FileReader, не показали содержимое файла, не сказали кодировку файла, и не показали вывод программы. Мы не экстрасенсы.
0
Джал
13 июля 2018, 15:17
1. Как использую:
2.1. Содержимое файла source:
строка 1
2.2. Содержимое файла source2:
строка 1
строка 0
3.
![]()
0
Джал
15 июля 2018, 00:44
Все еще не могу понять почему возникает проблема с кодировкой.
0
Джал
15 июля 2018, 12:41
Тему вверх
0
Джал
15 июля 2018, 17:59
Ярослав, помогите пожалуйста.
0
Ярослав Java Developer Master
15 июля 2018, 22:01решение
Скорее всего, вы просто храните текст в файле в другой кодировке, а нужно хранить в UTF-8.
+2