Є баг, який хоч раз ловить майже кожен, хто вчить Python. Пишеш numbers = numbers.sort(), запускаєш — і в numbers лежить None. Список ніби відсортувався — і тут же зник.
Python тут ні до чого, він зробив рівно те, що йому сказали. Просто sort і sorted виглядають як близнюки, а поводяться по-різному. Розберімося раз і назавжди — а заразом пройдемо все, що трапляється на практиці: ключі, словники, обʼєкти, кілька полів, кирилицю і швидкість.
Чим sorted відрізняється від sort
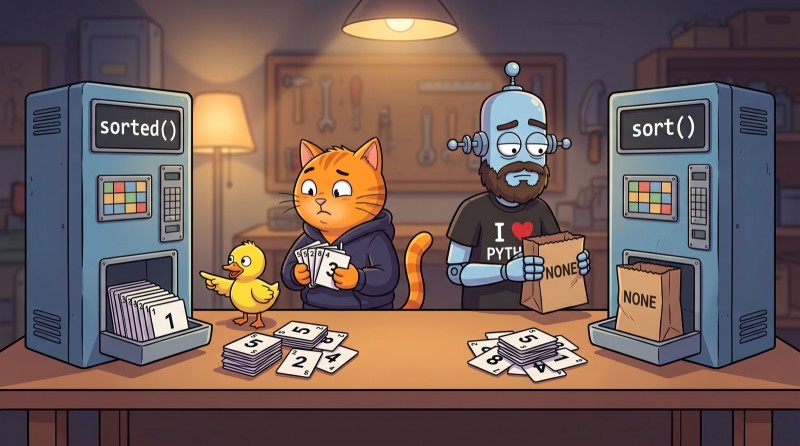
Якщо зовсім коротко: sorted() — це функція, яка повертає новий відсортований список і не чіпає вихідні дані. list.sort() — це метод списку, який сортує його на місці й повертає None.
scores = [42, 7, 19]

fresh = sorted(scores)
print(scores)  # [42, 7, 19] — вихідний список не змінився
print(fresh)   # [7, 19, 42] — це новий список

fresh = scores.sort()
print(scores)  # [7, 19, 42] — тепер змінився сам список
print(fresh)   # None
Ось і розгадка бага з початку: .sort() відпрацював, відсортував список, повернув None — і цей None записався поверх списку. Повернення None — свідоме рішення авторів Python: метод, який змінює обʼєкт, нічого не повертає, щоб ніхто не сплутав його з функцією, що створює копію.
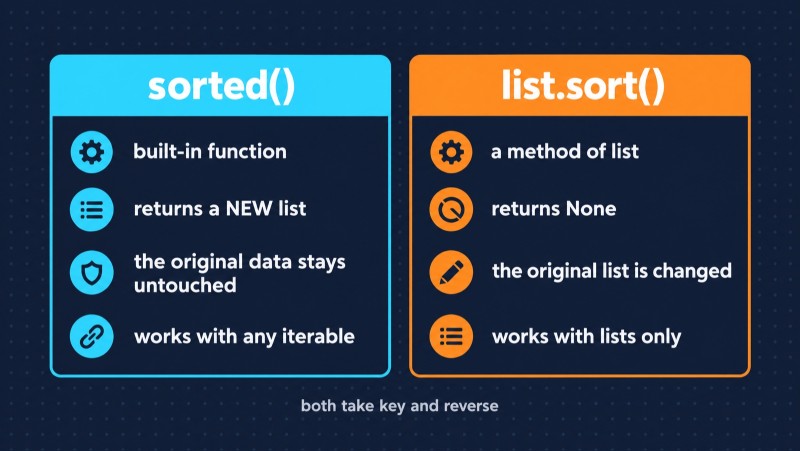
sorted() | list.sort() | |
| Що це | вбудована функція | метод списку |
| Що повертає | новий список | None |
| Вихідні дані | не змінюються | змінюються |
| З чим працює | будь-який ітерований обʼєкт: список, кортеж, рядок, словник, множина | лише список |
| Коли брати | потрібен оригінал або в тебе не список | список великий, оригінал не потрібен |
Важлива деталь: sorted() завжди повертає список, що б ти йому не дав.
sorted((3, 1, 2))       # [1, 2, 3] — з кортежу вийшов список
sorted("python")        # ['h', 'n', 'o', 'p', 't', 'y']
"".join(sorted("python"))  # 'hnopty'
Сортування за спаданням: reverse
В обох інструментів однакові параметри: key і reverse. Передавати їх можна лише за іменем — numbers.sort(True) видасть TypeError.
cities = ["Одеса", "Варшава", "Мадрид"]

sorted(cities)                # ['Варшава', 'Мадрид', 'Одеса']
sorted(cities, reverse=True)  # ['Одеса', 'Мадрид', 'Варшава']
Сортування за ключем: параметр key
key — головний параметр сортування. Ти передаєш функцію, Python викликає її для кожного елемента й сортує за тим, що вона повернула. Самі елементи при цьому не змінюються.
Візьмімо список співробітників — далі працюватимемо з ним:

employees = [
    {"name": "Марта", "dept": "Dev", "salary": 4200},
    {"name": "Денис", "dept": "QA", "salary": 2600},
    {"name": "Ліза", "dept": "Dev", "salary": 3100},
    {"name": "Карина", "dept": "Design", "salary": 2900},
]
lambda — для швидких ключів
by_salary = sorted(employees, key=lambda e: e["salary"])itemgetter і attrgetter — те саме, але швидше
У модулі operator є готові функції для доступу до поля словника й атрибута обʼєкта. Вони написані на C, тому працюють швидше за lambda.
from operator import itemgetter

by_salary = sorted(employees, key=itemgetter("salary"))
Наскільки швидше? Ми заміряли на свіжому Python 3.15 і ста тисячах словників: itemgetter обігнав lambda приблизно на 10%. Приємно, але не революція — на коротких списках різниці не помітиш. Бери itemgetter, коли сортуєш багато й часто, і lambda — коли так зрозуміліше.
Готові функції та методи
У key можна передати будь-яку функцію з одним аргументом, зокрема вбудовану. Головне — передавати саму функцію, без дужок.
words = ["banana", "kiwi", "Cherry"]

sorted(words)                 # ['Cherry', 'banana', 'kiwi'] — великі літери йдуть раніше
sorted(words, key=str.lower)  # ['banana', 'Cherry', 'kiwi'] — без урахування регістру
sorted(words, key=len)        # ['kiwi', 'banana', 'Cherry'] — за довжиною
Сортування за кількома полями
Ключ-кортеж
Якщо key повертає кортеж, Python порівнює його поелементно: спершу перше значення, за рівності — друге і так далі. Щоб одне з числових полів ішло за спаданням, ставимо перед ним мінус.
# за відділом, усередині відділу — за зарплатою від більшої до меншої
result = sorted(employees, key=lambda e: (e["dept"], -e["salary"]))
Два проходи — коли мінус не поставиш
Мінус працює лише з числами. Якщо за спаданням треба відсортувати рядок, рятує стабільність: сортування в Python ніколи не змінює порядок елементів з однаковим ключем. Тому можна відсортувати у два проходи — спершу за другорядним полем, потім за головним.
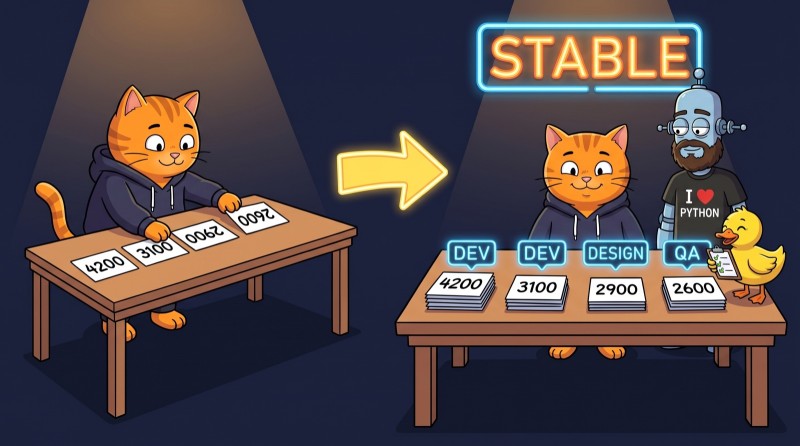
from operator import itemgetter

# 1. другорядне поле: зарплата за спаданням
step1 = sorted(employees, key=itemgetter("salary"), reverse=True)
# 2. головне поле: відділ за алфавітом — порядок зарплат усередині відділу збережеться
result = sorted(step1, key=itemgetter("dept"))
Прийнято вважати, що кортеж швидший, адже прохід один. Ми перевірили на тих самих ста тисячах словників — і два проходи з itemgetter виявилися швидшими за кортеж із lambda приблизно в півтора раза: 16 мілісекунд проти 27. Створити сто тисяч кортежів і порівнювати їх поелементно теж не безкоштовно. Мораль проста: обирай те, що читається зрозуміліше, а про швидкість думай, коли замір показав проблему.
Як відсортувати словник
Сам словник відсортувати не можна, зате можна отримати відсортовані ключі чи пари й зібрати з них новий словник — з Python 3.7 словники зберігають порядок вставлення.
grades = {"Тимур": 72, "Віра": 95, "Олег": 88}

sorted(grades)  # ['Віра', 'Олег', 'Тимур'] — лише ключі

# за значенням, від більшого до меншого
top = dict(sorted(grades.items(), key=lambda kv: kv[1], reverse=True))
print(top)  # {'Віра': 95, 'Олег': 88, 'Тимур': 72}
Потрібні лише найкращі N? Не сортуй усе
Часта задача — знайти топ-10 найбільших значень. Перше, що спадає на думку: відсортувати й узяти зріз. Але сортувати мільйон елементів заради десяти — марнотратно. Для цього є модуль heapq:
import heapq

top10 = heapq.nlargest(10, numbers)
cheapest = heapq.nsmallest(3, products, key=lambda p: p["price"])
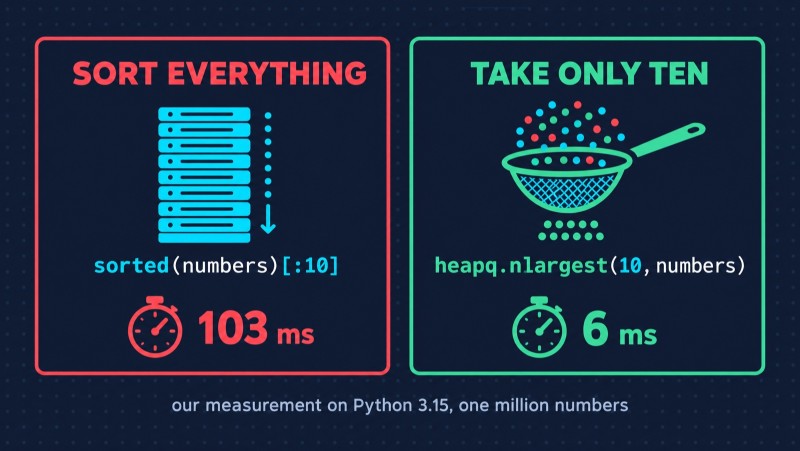
У нашому замірі на списку з мільйона чисел heapq.nlargest(10, ...) виявився майже у 18 разів швидшим, ніж sorted(...)[:10]: 6 мілісекунд проти 103.
Сортування обʼєктів
Якщо дані лежать в обʼєктах, ключ будується так само, лише через attrgetter:
from dataclasses import dataclass
from operator import attrgetter

@dataclass
class Employee:
    name: str
    salary: int

staff = [Employee("Марта", 4200), Employee("Денис", 2600)]
sorted(staff, key=attrgetter("salary"))
А якщо обʼєкти треба сортувати завжди однаково, навчи їх порівнюватися: для dataclass достатньо @dataclass(order=True) — порівняння піде за полями в порядку оголошення.
Пʼять пасток, на яких ламається сортування
1. None у списку
sorted([3, None, 1])
# TypeError: '<' not supported between instances of 'NoneType' and 'int'
Python 3 не вміє порівнювати None з числами. Рішення — ключ, який відправляє None у кінець:
sorted([3, None, 1], key=lambda x: (x is None, x)) # [1, 3, None]2. Різні типи
sorted([3, "2", 1]) впаде з тією самою помилкою: рядок із числом порівняти не можна. Зазвичай це означає, що дані прийшли «брудними», наприклад із CSV. Зводь до одного типу до сортування, а не всередині нього.
3. Числа всередині рядків
files = ["file10.txt", "file2.txt", "file1.txt"]
sorted(files)  # ['file1.txt', 'file10.txt', 'file2.txt']
Рядки порівнюються посимвольно, і «1» у «10» менша за «2». Щоб отримати звичний людині порядок — так зване природне сортування, — розбий рядок на текст і числа:
import re

def natural_key(s):
    return [int(part) if part.isdigit() else part.lower()
            for part in re.split(r"(\d+)", s)]

sorted(files, key=natural_key)  # ['file1.txt', 'file2.txt', 'file10.txt']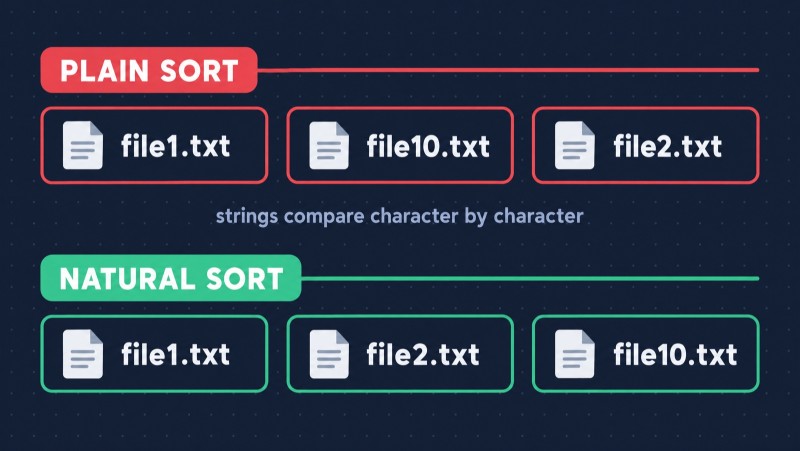
4. Літери «є», «і», «ї», «ґ»
А ось пастка, про яку в англомовних туторіалах не пишуть:
sorted(["їжак", "яблуко", "ґанок", "гора"]) # ['гора', 'яблуко', 'їжак', 'ґанок']Ґанок опинився в самому кінці, після яблука. Python порівнює рядки за кодами символів Unicode, а «є», «і», «ї» і «ґ» стоять у таблиці не в ряду «а»–«я», а після «я». З великими літерами те саме: «Я» йде раніше за малу «а».
Для сортування за правилами мови є модуль locale:
import locale

locale.setlocale(locale.LC_COLLATE, "uk_UA.UTF-8")
sorted(["їжак", "яблуко", "ґанок", "гора"], key=locale.strxfrm)  # ['гора', 'ґанок', 'їжак', 'яблуко']
Нюанс: результат залежить від того, які локалі встановлені в системі, а на Windows вони називаються інакше. Якщо сортувати по-людськи потрібно в продакшені, надійніша бібліотека PyICU — вона однаково працює всюди.
5. Присвоєння результату sort
Той самий баг із початку. x = x.sort() — це завжди None. Або x.sort() окремим рядком, або x = sorted(x).
Що під капотом
Сортування в Python — не навчальна «бульбашка», а гібридний алгоритм, заточений під реальні дані. З версії 2.3 це був Timsort, а з Python 3.11 його схему злиттів замінили на Powersort — надійнішу, з доведеними гарантіями.
Що важливо знати на практиці:
- Складність — O(n log n) у найгіршому випадку.
- Сортування стабільне, і це гарантовано документацією. На цьому тримається трюк із двома проходами.
- Майже відсортовані дані сортуються дуже швидко. Алгоритм знаходить уже впорядковані шматки й просто склеює їх. У нашому замірі вже відсортований список із мільйона чисел сортувався приблизно в 9 разів швидше, ніж перемішаний.
Усі заміри ми робили на Python 3.15.1, на ноутбуці з Apple Silicon. На іншому залізі абсолютні цифри будуть іншими, але порядок співвідношень зазвичай зберігається. Захочеш перевірити в себе — вистачить модуля timeit і пʼяти рядків коду.
Навіщо це знати, якщо код пише AI

Слушне запитання. Попроси будь-яку нейромережу відсортувати список словників за зарплатою — отримаєш робочий код за секунду. Але AI з тією самою впевненістю напише data = data.sort(), не подумає про None у даних із бази й відсортує прізвища на «Ґ» чи «Є» не туди. Код виглядатиме правильно й пройде побіжний погляд.
Помітити таку помилку може лише той, хто розуміє, як працює сортування. У цьому й різниця між тим, хто користується AI, і тим, кого AI робить у рази сильнішим: інструмент прискорює того, хто має фундамент.
Фундамент Python будується на практиці, а не на читанні. На курсі Python у JavaRush це 52+ рівні задач із миттєвою перевіркою і ще 10 рівнів з алгоритмів і структур даних — де сортування розбирають не на рівні «виклич sorted», а зсередини. Якщо не знаєш, з чого почати шлях у Python загалом, зазирни в наш роадмап Python-розробника 2026.
Часті запитання
У чому різниця між sort і sorted у Python? sorted() — вбудована функція: приймає будь-який ітерований обʼєкт і повертає новий відсортований список, не змінюючи вихідні дані. list.sort() — метод списку: сортує список на місці й повертає None.
Чому list.sort() повертає None? Це свідоме рішення авторів Python: методи, які змінюють обʼєкт на місці, повертають None, щоб їх не плутали з функціями, що створюють новий обʼєкт. Тому x = x.sort() записує в змінну None.
Як відсортувати список за спаданням у Python? Передати параметр reverse=True: sorted(data, reverse=True) або data.sort(reverse=True).
Як відсортувати словник за значенням у Python? Відсортувати пари за другим елементом і зібрати новий словник: dict(sorted(d.items(), key=lambda kv: kv[1])). Для спадання додати reverse=True.
Як відсортувати список за кількома полями? Передати в key функцію, яка повертає кортеж: key=lambda e: (e["dept"], -e["salary"]). Якщо поле не можна розвернути мінусом, наприклад рядок, відсортувати у два проходи: спершу за другорядним полем, потім за головним — стабільність сортування збереже порядок.
Який алгоритм сортування використовує Python? До версії 3.10 включно — Timsort, з Python 3.11 — його покращений варіант Powersort. Обидва гібридні, стабільні, працюють за O(n log n) і особливо швидкі на частково впорядкованих даних.
ПЕРЕЙДІТЬ В ПОВНУ ВЕРСІЮ