Мільйон вихідних токенів GPT-5.5 через API коштує $30. У Claude Sonnet 5.5 — $10. У DeepSeek V4.1 Flash — від $0,60.
Це не помилка. Різниця — в десятки разів. А ще модель DeepSeek можна завантажити повністю й запустити на своєму сервері, бо її ваги опубліковані під ліцензією MIT. Хоч завтра вбудовуй у продукт.
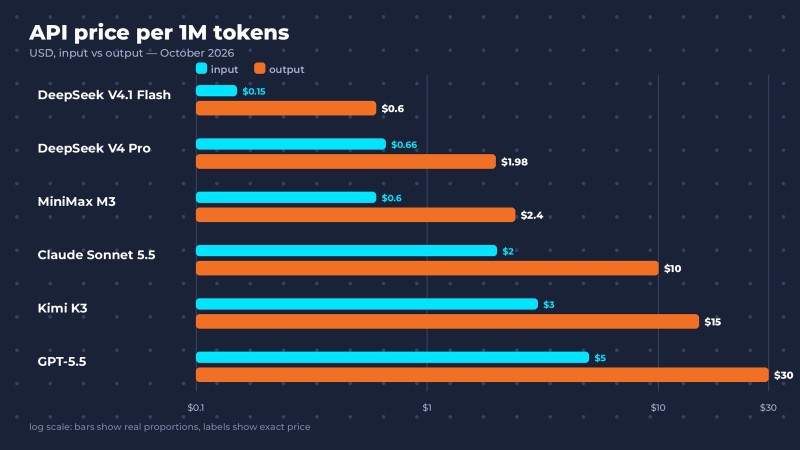
Звучить як розвод із реклами в соцмережах. Але це реальність 2026 року: китайські лабораторії випускають моделі рівня західних флагманів майже щомісяця й роздають їх безкоштовно. Розробники в усьому світі вже цим користуються.
Розберімося, що це за моделі, на що вони реально здатні, як підключити їх до Claude Code — і де починається підступ. Він є, і не один.
Що таке відкриті моделі і чому це важливо
Якщо зовсім коротко: відкрита модель (open-weight) — це нейромережа, чиї ваги опубліковані для завантаження. Її можна запустити на своєму залізі, донавчити під свою задачу й вбудувати в продукт без підписки і без надсилання даних у чужу хмару.
ChatGPT і Claude — закриті моделі. Ти користуєшся ними лише через сайт, застосунок або API, а сама модель живе на серверах OpenAI та Anthropic. Відкриту модель можна отримати у власність: завантажив — і вона твоя, на твоїх умовах. Наскільки твоя — залежить від ліцензії, але про це нижче.
Чому китайці роздають моделі безкоштовно
Ще кілька років тому відкриті моделі асоціювалися передусім із Llama від Meta. У 2026 році картина інша. За весняним звітом Hugging Face, з лютого 2025-го по лютий 2026-го на китайські відкриті моделі припало 41% усіх завантажень на платформі. На американські — 36,5%.
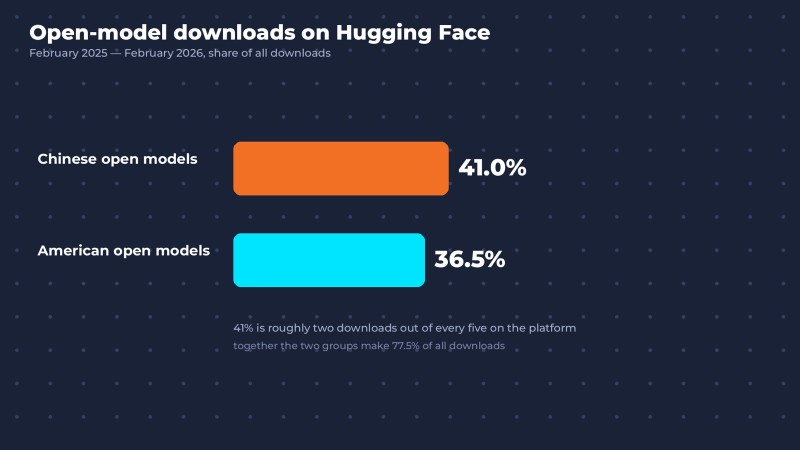
Сімейство Qwen від Alibaba за різними оцінками перевалило за мільярд завантажень і обігнало Llama. На його основі люди донавчили більше похідних моделей, ніж на основі будь-якого іншого сімейства.
Чому китайські компанії роздають те, за що OpenAI та Anthropic беруть гроші? Причин кілька:
- Це стратегія захоплення ринку. Коли розробники по всьому світу будують продукти на твоїй моделі, ти стаєш стандартом. Гроші потім приходять від хмари, корпоративних клієнтів і наступних моделей.
- Конкуренція всередині Китаю. DeepSeek, Alibaba, Moonshot, Zhipu, MiniMax і ByteDance змагаються одне з одним так жорстко, що нова версія в когось виходить майже щотижня.
- Ціна навчання впала. Китайські лабораторії навчилися тренувати сильні моделі дешевше, зокрема в умовах обмежень на постачання американських чипів.
Для розробника висновок простий: вибір моделей у 2026 році більший, ніж будь-коли, і частина цього вибору безкоштовна.
Головні китайські нейромережі 2026 року
Одразу важливе застереження. Версії тут змінюються так швидко, що будь-який огляд застаріває за кілька місяців. Нижче — стан на кінець жовтня 2026 року.
DeepSeek V4: найдешевший API
Та сама компанія, яка в січні 2025-го обвалила акції Nvidia. Зараз у DeepSeek дві основні моделі: V4 Pro і V4.1 Flash. Останню версію Flash виклали 17 жовтня 2026 року, ваги відкриті під ліцензією MIT, контекст — до мільйона токенів.
Сильна сторона — ціна. Flash коштує в десятки разів дешевше за західні флагмани, а в непікові години — ще приблизно вдвічі дешевше. Для фонової автоматизації, обробки документів і масових задач це майже безкоштовно.

Слабка сторона — надійність у складних агентних задачах. Tom's Hardware, розбираючи нову модель, окремо зазначив: вона економно витрачає памʼять, але частіше за пропрієтарних конкурентів галюцинує в агентних сценаріях.
Qwen 3.8: найпопулярніша відкрита модель
Сімейство моделей від Alibaba. Актуальне покоління — Qwen 3.8, а Qwen 4, за словами Alibaba, зараз у навчанні. Головна перевага Qwen — вибір розмірів: від компактних моделей, які реально запустити на своєму компʼютері, до важких флагманів. Молодші версії виходять під ліцензією Apache 2.0, однією з найвільніших.
Якщо тобі потрібна відкрита модель, яку можна донавчити під свою задачу, Qwen — перший кандидат. Саме тому на його основі роблять найбільше похідних моделей.
Kimi K3: флагман для коду й агентів
Модель від Moonshot AI. K3 вийшла 16 липня 2026 року, а через два тижні Moonshot опублікувала її ваги. Розмір вражає: 2,8 трильйона параметрів і контекст у мільйон токенів. Модель заточена під довгі агентні задачі: навігацію великими репозиторіями, відлагодження, роботу з інструментами й логами.
Kimi ми вже бачили в новинах: нещодавно він знайшов RCE-вразливість у Redis за 27 хвилин.
Нюанс — ліцензія. Вона не MIT, а власна: провайдери, які заробляють на інференсі K3 понад $20 млн на рік, мають ділитися виручкою. Для тебе як розробника це навряд чи стане проблемою, але читати ліцензію перед використанням у продукті варто завжди.
GLM-5: відкрита модель для кодингу
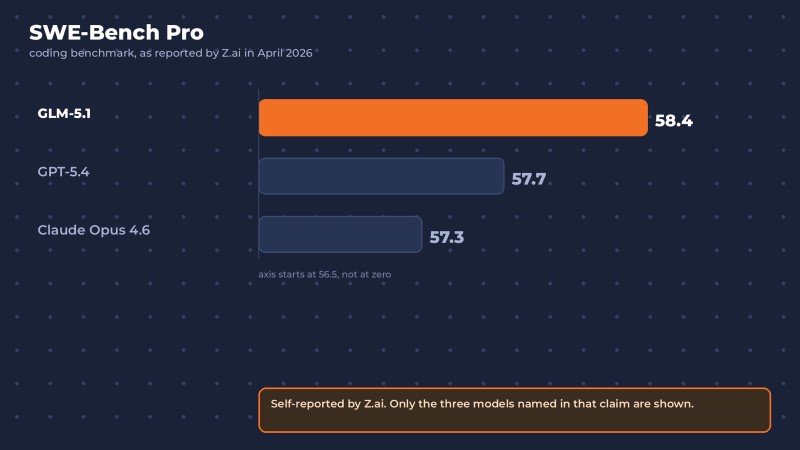
Лінійка від Z.ai, колишньої Zhipu AI. У квітні 2026 року компанія відкрила ваги GLM-5.1 під ліцензією MIT, і за власними замірами Z.ai модель вийшла на перше місце в бенчмарку SWE-Bench Pro, випередивши GPT-5.4 і Claude Opus 4.6. Застереження: результат заявлений самою компанією, а відтоді Z.ai випустила ще кілька версій — релізи тут ідуть майже щомісяця.
Для розробників у Z.ai є окремий GLM Coding Plan — підписка від $18 на місяць, яка працює просто всередині Claude Code. Про це нижче.
MiniMax M3: мільйон токенів і мультимодальність
Модель від MiniMax, що вийшла влітку 2026 року з відкритими вагами. Компанія робить ставку на поєднання трьох речей в одній моделі: сильного кодингу, контексту в мільйон токенів і нативної роботи з картинками. Добрий варіант, коли потрібно згодувати моделі великий обсяг документації або коду цілком.
Seedream і Seedance: картинки й відео від ByteDance
Китайські компанії сильні не лише в текстових моделях. ByteDance — та, що зробила TikTok, — випускає генератори картинок і відео, які змагаються з найкращими західними.
Seedream 5.0 — генератор зображень. ByteDance випустила його в лютому 2026 року як дешевшу альтернативу Nano Banana Pro від Google, а влітку додала версію Pro. Модель видає картинки у 2K і 4K, уміє редагувати зображення за референсами й у полегшеній версії навіть шукає інформацію в інтернеті перед генерацією. Через OpenRouter одна картинка Seedream 5.0 Pro коштує близько $0,045.
Seedance 2.0 — генератор відео. З весни 2026 року він вбудований просто в CapCut і Dreamina, а на Dreamina вже зʼявилася версія 2.5, яка генерує ролики до 30 секунд. Для розробника є API через BytePlus.
Навіщо це розробнику? Бо продукт — це не лише код. Іконки, ілюстрації для лендингу, асети для гри, демо-ролик для запуску — раніше на все це потрібен був дизайнер, відеомонтажер і бюджет. Зараз першу версію можна зібрати за вечір. Одна людина з кодом і такими інструментами випускає те, що раніше вимагало маленької команди.
Порівняння: яку модель обрати
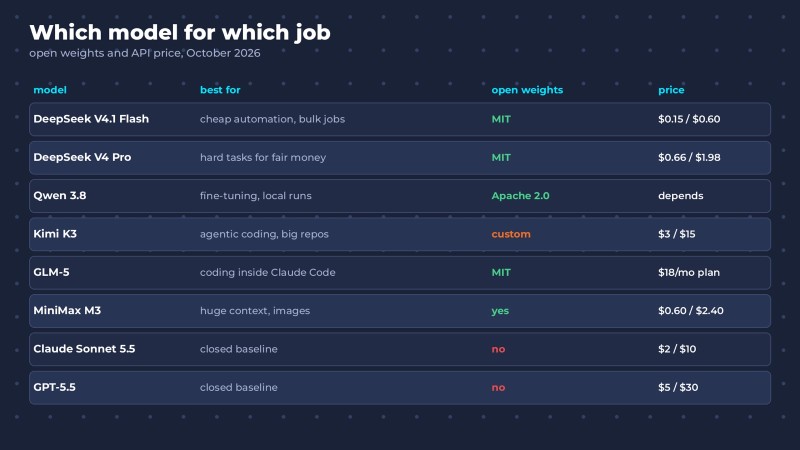
| Модель | Для чого найкраще | Відкриті ваги | Ціна API (за 1 млн токенів, вхід / вихід) |
| DeepSeek V4.1 Flash | Дешева автоматизація, масові задачі | Так, MIT | від $0,15 / $0,60 |
| DeepSeek V4 Pro | Складні задачі за помірні гроші | Так, MIT | близько $0,66 / $1,98 |
| Qwen 3.8 | Донавчання, локальний запуск, вибір розмірів | Так, молодші версії — Apache 2.0 | залежить від розміру й провайдера |
| Kimi K3 | Агентний кодинг, великі репозиторії | Так, власна ліцензія | $3 / $15 |
| GLM-5 | Кодинг, робота в Claude Code | Так, MIT | Coding Plan від $18 на місяць |
| MiniMax M3 | Величезний контекст, картинки + код | Так | близько $0,60 / $2,40 |
| Для порівняння: Claude Sonnet 5.5 | — | Ні | $2 / $10 |
| Для порівняння: GPT-5.5 | — | Ні | $5 / $30 |
Ціни в китайських провайдерів змінюються часто, бувають знижки на запуск і різні тарифи для пікового й нічного часу. Перш ніж закладати вартість у продукт, звіряйся з офіційною сторінкою цін.
Як підключити китайську модель до Claude Code
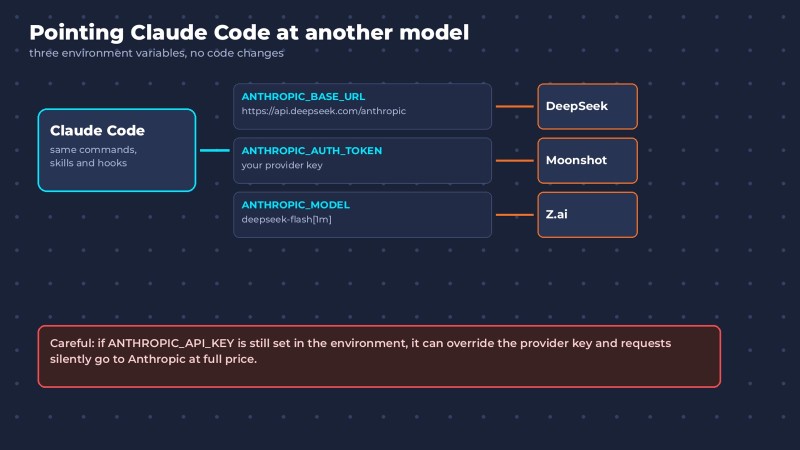
А тепер найпрактичніше. Claude Code вміє працювати не лише з моделями Claude. Він надсилає запити на адресу зі змінної оточення ANTHROPIC_BASE_URL, а DeepSeek, Moonshot і Z.ai зробили в себе API, сумісні з форматом Anthropic.
Ось офіційне налаштування з документації DeepSeek:
export ANTHROPIC_BASE_URL=https://api.deepseek.com/anthropic
export ANTHROPIC_AUTH_TOKEN=<твій ключ DeepSeek API>
export ANTHROPIC_MODEL=deepseek-flash[1m]
export ANTHROPIC_DEFAULT_OPUS_MODEL=deepseek-flash[1m]
export ANTHROPIC_DEFAULT_SONNET_MODEL=deepseek-flash[1m]
export ANTHROPIC_DEFAULT_HAIKU_MODEL=deepseek-flash
export CLAUDE_CODE_SUBAGENT_MODEL=deepseek-flash
claude
Суфікс [1m] вмикає контекст у мільйон токенів. Якщо в налаштуваннях залишити імена моделей Claude, DeepSeek сам перенаправить запити: Opus — на V4 Pro, Sonnet і Haiku — на Flash.
Після цього Claude Code працює як завжди — ті самі команди, ті самі скіли, ті самі субагенти, — але думає за нього DeepSeek. У Moonshot для Kimi K3 і в Z.ai для GLM схема та сама: своя адреса API і свій ключ.
Три речі, які варто знати заздалегідь:
- Це не офіційно підтримувана Anthropic конфігурація. Її документують самі китайські провайдери. Щось може працювати інакше: наприклад, у меню
/modelкитайські моделі не зʼявляться, а перевірити, яка модель зараз відповідає, можна через/status. - Стеж за змінною
ANTHROPIC_API_KEY. Якщо вона залишилася в оточенні, вона може перебити ключ провайдера, і запити мовчки підуть в Anthropic за повною ціною. - Якість буде іншою. Claude Code налаштований під моделі Claude. На простих задачах різниця майже непомітна, на довгих агентних сесіях — помітна.
Як влаштовані сам агент, скіли, субагенти й хуки, ми детально розбирали в статті «Як влаштований ШІ-агент».
Де підступ
Захоплені огляди зазвичай на цьому закінчуються. Ми — ні. Ось чотири речі, які варто розуміти до того, як переводити роботу на китайську модель.
1. «Запустити в себе» — це не про ноутбук
Огляди люблять писати, що китайські моделі можна запустити через Ollama або LM Studio просто на своєму компʼютері. Технічно — так. Практично — лише маленькі версії. Флагман GLM-5.1 важить близько 744 мільярдів параметрів, Kimi K3 — 2,8 трильйона. Щоб запустити таке, потрібен не ноутбук, а серверна стійка з кількома дорогими відеокартами.
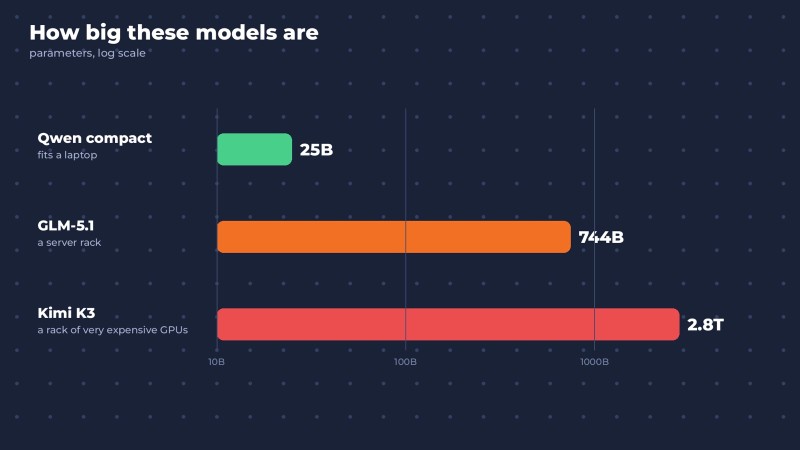
На звичайному компʼютері реально працюють компактні дистильовані моделі — наприклад, молодші версії Qwen на 20–30 мільярдів параметрів. Вони корисні, але до флагманів не дотягують.
2. Куди йдуть твої дані
Відкрита модель на своєму сервері — це одне. Хмарний API китайської компанії — зовсім інше. Політика конфіденційності DeepSeek прямо каже, що запити й завантажені файли зберігаються на серверах у Китаї. Саме тому Австралія заборонила DeepSeek на державних пристроях, регулятор Італії вимагав прибрати застосунок із магазинів, а Чехія й Тайвань заборонили його в держструктурах.
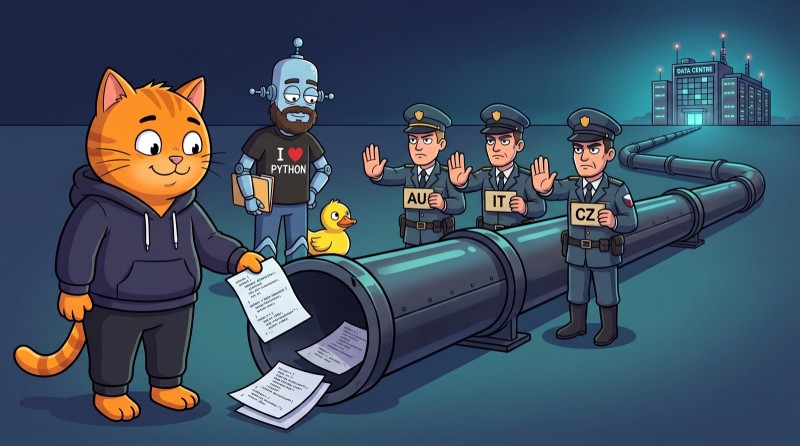
Практичне правило: особистий пет-проєкт через китайський API — будь ласка. Робочий код компанії, ключі, дані клієнтів — лише через локальний запуск або через західного провайдера, який хостить відкриті ваги в себе. Ваги ті самі, а дані залишаються під твоїм контролем.
3. Нейрослоп ніхто не скасовував
Дешева модель помиляється не рідше за дорогу, а іноді й частіше. На складній логіці й довгих агентних задачах китайські моделі помітно частіше впевнено видають неробочий код або вигадують неіснуючі методи. Бенчмарки, які публікують самі компанії, варто ділити на два: вони вимірюють те, що зручно вимірювати.
4. «Відкрита» не означає «роби що хочеш»
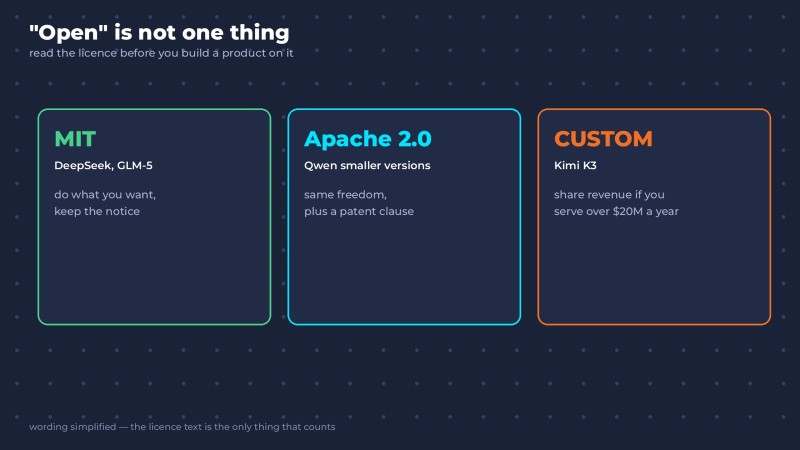
MIT і Apache 2.0 — справді вільні ліцензії. А от у Kimi K3 ліцензія власна, з умовами для великих комерційних провайдерів. Перш ніж будувати на моделі продукт, витрать десять хвилин і прочитай ліцензію. Це дешевше, ніж потім переробляти архітектуру.
Що це означає для розробника
Є стара думка, яку ми повторюємо вже багато років: інструменти обнуляються, фундамент залишається. Китайські моделі показують це найнаочніше.
Ще рік тому доступ до сильної моделі був перевагою. Зараз модель рівня флагмана можна отримати безкоштовно, а за місяць вийде наступна — і теж безкоштовно. Моделі стають сировиною, як електрика. Ніхто не пишається тим, що в нього в розетці є струм.
Цінність зміщується до того, хто вміє цим струмом користуватися. Обрати модель під задачу й бюджет. Підключити її до агента. Перевірити, що вона написала, — і помітити, де вона впевнено помилилася. Налаштувати права так, щоб агент не накоїв лиха. Це і є навичка, за яку платять. І вона не знецінюється з виходом наступної моделі — навпаки, дорожчає.

Найкраща модель — не та, що вища в бенчмарку, а та, результат якої ти вмієш перевірити.
Де цього навчитися
Працювати з агентами так, щоб не залежати від однієї конкретної моделі, — саме те, чому присвячений наш курс з Claude Code від AI Academy. 16 рівнів і 200+ задач: права й контекст, скіли, субагенти, MCP, хуки, plan mode і контроль через git. Усе це працює однаково, яка б модель не стояла під капотом.
А якщо хочеться перебудувати на агентах усю роботу й розібратися системно, з ментором і проєктами, для цього є AI Native Developer у JavaRush University.
Часті запитання
Які китайські нейромережі найкращі у 2026 році? На кінець жовтня 2026 року основні — DeepSeek V4 (найдешевший API), Qwen 3.8 від Alibaba (найпопулярніша відкрита модель), Kimi K3 від Moonshot AI (агентний кодинг і великі репозиторії), лінійка GLM-5 від Z.ai (кодинг, робота в Claude Code) і MiniMax M3 (контекст у мільйон токенів і мультимодальність). Для картинок і відео — Seedream 5.0 і Seedance 2.0 від ByteDance.
Чи можуть китайські нейромережі замінити ChatGPT і Claude? Для багатьох задач — так: автоматизація, обробка документів, генерація коду середньої складності. На складній логіці й довгих агентних сценаріях китайські моделі поки частіше помиляються. Головні плюси — ціна API в десятки разів нижча й можливість запустити модель на своєму сервері.
Скільки коштує API китайських нейромереж? DeepSeek V4.1 Flash коштує від $0,15 за мільйон вхідних і $0,60 за мільйон вихідних токенів. Kimi K3 — $3 і $15. Для порівняння: Claude Sonnet 5.5 — $2 і $10, GPT-5.5 — $5 і $30. Ціни часто змінюються, тому звіряйся з офіційними сторінками провайдерів.
Чи можна запустити китайську нейромережу на своєму компʼютері? Лише компактні версії — наприклад, молодші моделі Qwen на 20–30 мільярдів параметрів через Ollama або LM Studio. Флагмани на кшталт GLM-5.1 (близько 744 мільярдів параметрів) або Kimi K3 (2,8 трильйона) потребують серверного заліза з кількома потужними відеокартами.
Чи безпечно надсилати код у китайські нейромережі? Через хмарний API — обережно: наприклад, DeepSeek зберігає запити й файли на серверах у Китаї, тому низка країн заборонила його на державних пристроях. Для робочого коду й даних клієнтів надійніше запускати відкриті ваги локально або через західного провайдера, який хостить їх у себе.
Як підключити DeepSeek або Kimi до Claude Code? Через змінні оточення: задати ANTHROPIC_BASE_URL на Anthropic-сумісну адресу провайдера (наприклад, https://api.deepseek.com/anthropic), ключ провайдера в ANTHROPIC_AUTH_TOKEN і імʼя моделі в ANTHROPIC_MODEL. Це задокументована провайдерами, але не офіційно підтримувана Anthropic конфігурація.
ПЕРЕЙДІТЬ В ПОВНУ ВЕРСІЮ