Приведение примитивных типов в Java это перевод значения из одного типа в другой. Если значение переносят в более емкий тип, например
byte в
int, компилятор делает это сам, и такое преобразование называют расширением. Обратный перенос, из большего типа в меньший, называют сужением: его записывают явно, приведением вида
(short), и часть данных при этом может потеряться.
Кратко
- Расширение (widening) это преобразование из меньшего типа в больший. Компилятор выполняет его автоматически, данные не теряются.
- Сужение (narrowing) это преобразование из большего типа в меньший. Его пишут явно:
(short) bigNumber, иначе будет ошибка компиляции. - При сужении целых чисел лишние старшие биты просто отбрасываются, поэтому результат может оказаться отрицательным или неожиданным.
- При приведении
double или float к целому типу дробная часть отбрасывается, округления не происходит. char занимает 16 бит и хранит код символа в Юникоде, диапазон от 0 до 65535.- В арифметике
char превращается в свой числовой код, поэтому 1 + '1' дает 50, а не 2.
Привет! Во время прохождения JavaRush ты не раз сталкивался с примитивными типами.
Примитивные типы и их диапазоны
Вот краткий список того, что мы о них знаем:
- Они не являются объектами и представляют собой значение, хранящееся в памяти
- Примитивные типы бывают нескольких видов:
- Целые числа:
byte, short, int, long
- Числа с плавающей точкой (дробные):
float и double
- Логический:
boolean
- Символьный (для обозначения букв и цифр):
char
- Каждый из них имеет свой диапазон значений:
| Примитивный тип |
Размер в памяти |
Диапазон значений |
| byte |
8 бит |
от -128 до 127 |
| short |
16 бит |
от -32768 до 32767 |
| char |
16 бит |
от 0 до 65535 |
| int |
32 бита |
от -2147483648 до 2147483647 |
| long |
64 бита |
от -9223372036854775808
до 9223372036854775807
|
| float |
32 бита |
от (2 в степени -149)
до ((2-2 в степени -23)*2 в степени 127)
|
| double |
64 бита |
от (2 в степени -1074)
до ((2-2 в степени -52)*2 в степени 1023)
|
| boolean |
8 (при использовании в массивах),
32 (при использовании не в массивах)
|
true или false |
Но, помимо значений, типы отличаются еще и размером в памяти.
int занимает больше, чем
byte.
А
long больше, чем
short.
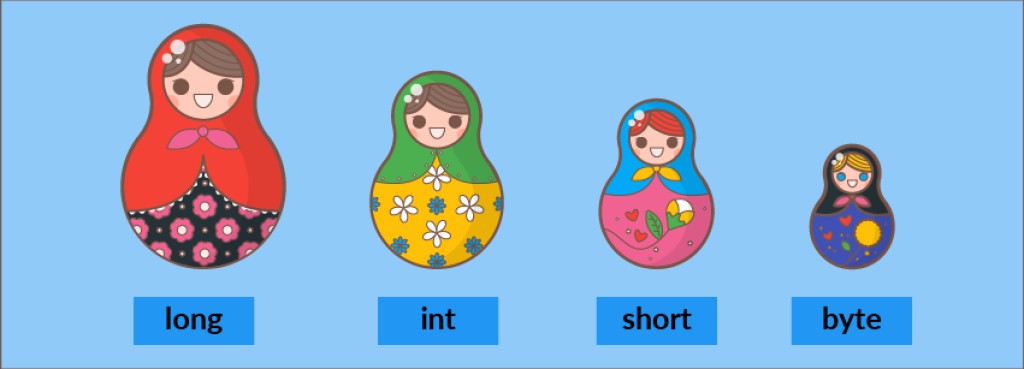
Объем занимаемой примитивами памяти можно сравнить с матрешками:
![Четыре матрешки разного размера с подписями long, int, short и byte: чем крупнее тип, тем больше памяти он занимает]()
Внутри матрешки есть свободное место. Чем больше матрешка, тем больше места.
Внутрь большой матрешки
long мы легко можем положить меньшую по размеру
int. Она легко уместится, и ничего делать дополнительно не нужно.
Расширение: автоматическое преобразование
В Java при работе с примитивами это называется автоматическим преобразованием. По-другому его называют расширением.
Вот простой пример расширения:
public class Main {

   public static void main(String[] args) {

       int bigNumber = 10000000;

       byte littleNumber = 16;

       bigNumber = littleNumber;
       System.out.println(bigNumber);
   }
}
Здесь мы присваиваем значение
byte в переменную
int. Присваивание прошло успешно и безо всяких проблем: значение, хранящееся в
byte, занимает меньший объем в памяти, чем “влезает” в
int.
“Маленькая матрешка” (значение
byte) легко влезает в “большую матрешку” (переменную
int).
Сужение: явное приведение типов
Другое дело, когда ты пытаешься сделать наоборот и положить значение большого размера в переменную, которая на такие размеры не рассчитана.
С настоящими матрешками такой номер в принципе не пройдет, а в Java пройдет, но с нюансами.
Давай попробуем положить значение
int в переменную
short:
public static void main(String[] args) {

   int bigNumber = 10000000;

   short littleNumber = 1000;

   littleNumber = bigNumber;//ошибка!
   System.out.println(bigNumber);
}
Ошибка!
Компилятор понимает, что ты пытаешься сделать что-то нестандартное, и засунуть большую матрешку (
int) внутрь маленькой (
short).
Ошибка компиляции в данном случае это предупреждение от компилятора: “
Эй, ты точно уверен, что хочешь это сделать?”
Если ты уверен, говоришь об этом компилятору: “
Все ок, я знаю, что делаю!”
Этот процесс называется явным преобразованием типов, или
сужением.
Чтобы сделать сужение, тебе необходимо явно указать тип, к которому ты хочешь привести свое значение.
Иными словами, ответить компилятору на его вопрос: “
Ну и в какую из этих маленьких матрешек ты хочешь засунуть эту большую матрешку?”
В нашем случае это будет выглядеть так:
public static void main(String[] args) {

   int bigNumber = 10000000;

   short littleNumber = 1000;

   littleNumber = (short) bigNumber;
   System.out.println(littleNumber);
}
Мы явно указали, что хотим уместить значение
int в переменную
short и берем ответственность на себя. Компилятор, видя явное указание на более узкий тип, проводит преобразование.
Каков же будет результат?
Вывод в консоль:
-27008Почему получилось -27008
Немного неожиданно. Почему именно такой? На самом деле все просто.
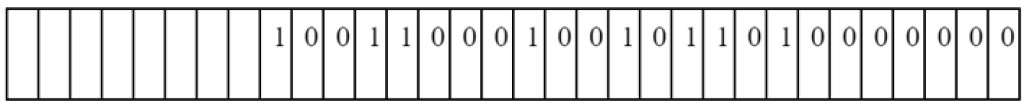
У нас было изначальное значение 10000000
Оно хранилось в переменной
int, которая занимала 32 бита, и в
двоичной форме оно выглядело так:
![Число 10000000 в двоичном виде: 32 разряда типа int, заполнены только младшие 24 бита]()
Мы записываем это значение в переменную
short, но она может хранить только 16 бит!
Соответственно, только младшие 16 бит нашего числа и будут туда перемещены, остальные отбросятся.
В итоге в переменную
short попадет значение
![Младшие 16 бит того же числа, которые попадают в переменную short: 1001011010000000]()
,
которое в десятичной форме как раз равно -27008
Именно поэтому компилятор “просил подтверждения” в форме явного приведения к конкретному типу. Во-первых, оно показывает, что ты берешь ответственность за результат на себя, а во-вторых, указывает компилятору сколько места выделить при приведении типов. Ведь если бы мы в последнем примере приводили
int к типу
byte, а не к
short, в нашем распоряжении было бы только 8 бит, а не 16, и результат был бы уже другим.
Сужение дробных типов
Для дробных типов (
float и
double) сужение происходит по-своему. Если попытаться привести такое число к целочисленному типу, у него будет отброшена дробная часть.
public static void main(String[] args) {

   double d = 2.7;

   long x = (int) d;
   System.out.println(x);
}
Вывод в консоль:
2Расширение и сужение: сравнение
Соберем оба преобразования в одну таблицу:
| Свойство | Расширение (widening) | Сужение (narrowing) |
|---|
| Направление | из меньшего типа в больший | из большего типа в меньший |
| Кто выполняет | компилятор, автоматически | программист, явным приведением |
| Как выглядит в коде | bigNumber = littleNumber; | littleNumber = (short) bigNumber; |
| Потеря данных | нет | возможна: лишние биты отбрасываются |
| Пример из статьи | byte в int | int в short |
Тип данных char
Ты уже знаешь, что тип char используется для отображения отдельных символов.
public static void main(String[] args) {

   char c = '!';
   char z = 'z';
   char i = '8';

}
Но у него есть ряд особенностей, которые важно понимать.
Давай еще раз посмотрим в таблицу с диапазонами значений:
| Примитивный тип |
Размер в памяти |
Диапазон значений |
| byte |
8 бит |
от -128 до 127 |
| short |
16 бит |
от -32768 до 32767 |
| char |
16 бит |
от 0 до 65535 |
| int |
32 бита |
от -2147483648 до 2147483647 |
| long |
64 бита |
от -9223372036854775808
до 9223372036854775807
|
| float |
32 бита |
от (2 в степени -149)
до ((2-2 в степени -23)*2 в степени 127)
|
| double |
64 бита |
от (2 в степени -1074)
до ((2-2 в степени -52)*2 в степени 1023)
|
| boolean |
8 (при использовании в массивах),
32 (при использовании не в массивах)
|
true или false |
Для типа
char указан числовой диапазон: от 0 до 65535.
Но что это значит? Ведь
char это не только цифры, но и буквы, знаки препинания…
Дело в том, что значения
char хранятся в Java в формате Юникода.
Мы уже сталкивались с
Юникодом в одной из прошлых лекций. Ты, наверное, помнишь, что
Unicode это стандарт кодирования символов, включающий в себя знаки почти всех письменных языков мира.
Иными словами, это список специальных кодов, в котором найдется код почти для любого символа из любого языка.
Общая таблица Юникодов очень большая, и, конечно, ее не нужно учить наизусть.
Вот, например, ее кусочек:
![Фрагмент таблицы Юникода, блок U+FB0x: лигатуры ff, fi, fl и буквы армянского и еврейского письма]()
Главное понимать принцип хранения значений
char и помнить, что
зная код конкретного символа всегда можно получить его в программе.
Давай попробуем это сделать с каким-нибудь случайным числом:
public static void main(String[] args) {

   int x = 32816;

   char c = (char) x ;
   System.out.println(c);
}
Вывод в консоль:
耰
Именно в таком формате в Java хранятся символы
char. Каждому символу соответствует число, числовой код размером 16 бит, или два байта. Юникоду 32816 соответствует иероглиф 耰.
Обрати внимание вот на какой момент.
В этом примере мы использовали переменную
int. Она занимает в памяти
32 бита, в то время как
char только
16.
Здесь мы выбрали
int, потому что нужное нам число 32816 находится за пределами диапазона
short. Хотя размер
char, как и short, равен 16 битам, но в диапазоне
char нет отрицательных чисел, поэтому “положительный” диапазон
char в два раза больше (65535 вместо 32767 у
short).
Мы можем использовать
int, пока наш код укладывается в диапазон до 65535.
Но если создать число
int >65535, оно будет занимать больше 16 битов.
И при сужении типов:
char c = (char) x;
лишние биты будут отброшены, и результат будет весьма неожиданным.
Особенности сложения char и целых чисел
Давай рассмотрим вот такой необычный пример:
public class Main {

   public static void main(String[] args) {

      char c = '1';

      int i = 1;

       System.out.println(i+c);
   }
}
Вывод в консоль:
50
O_О
Где логика?
1+1, откуда взялось 50?!
Ты уже знаешь, что значения
char хранятся в памяти как числа в диапазоне от 0 до 65535, обозначающие Юникод нашего символа.
![Фрагмент таблицы кодов символов: коду 49 соответствует символ 1, коду 50 символ 2]()
Так вот.
Когда мы производим
сложение char и какого-то целочисленного типа,
char преобразуется к числу, которое соответствует ему в Юникоде.
Когда в нашем коде мы складывали 1 и ‘1’, символ ‘1’ преобразовался к своему коду, который равен 49 (можешь проверить в таблице выше).
Поэтому результат и стал равен 50.
Давай еще раз возьмем для примера нашего старого друга
耰 и попробуем сложить его с каким-нибудь числом.
public static void main(String[] args) {

   char c = '耰';
   int x = 200;

   System.out.println(c + x);
}
Вывод в консоль:
33016
Мы уже выяснили, что
耰 соответствует коду 32816. А при сложении этого числа и 200 мы получаем как раз наш результат, 33016 :)
Механизм работы, как видишь, достаточно простой.
Вопросы и ответы
Чем расширение отличается от сужения типов?
Расширение это перенос значения в более емкий тип, например из byte в int. Компилятор делает его сам, данные не теряются. Сужение это обратный перенос, из большего типа в меньший. Его пишут явно, приведением вида (short), и часть данных при этом может пропасть.
Почему при приведении int к short получается отрицательное число?
Потому что в переменную попадают только младшие биты исходного числа, а остальные отбрасываются. Если старший из оставшихся битов равен единице, значение трактуется как отрицательное. Так int 10000000 при приведении к short превращается в -27008.
Нужно ли явное приведение, когда byte присваивают в int?
Нет. byte занимает 8 бит, int 32, поэтому значение помещается без потерь и компилятор выполняет расширение автоматически. Явное приведение нужно только в обратную сторону.
Что происходит с дробной частью при приведении double к int?
Она просто отбрасывается, округления не происходит. Например, (int) 2.7 даст 2, а не 3.
Почему сложение char и int дает число, а не символ?
Потому что в арифметических операциях char приводится к своему числовому коду в Юникоде. Символ с единицей в кавычках имеет код 49, поэтому 1 + '1' дает 50.
Любой ли символ помещается в один char?
Нет. char это 16 бит, то есть коды от 0 до 65535. Символы за этой границей, например многие эмодзи, Java хранит парой значений char, которую называют суррогатной парой.
Источник:
Oracle Java Tutorials: Primitive Data Types.
Читайте также
 Внутри матрешки есть свободное место. Чем больше матрешка, тем больше места.
Внутрь большой матрешки

 Мы записываем это значение в переменную
 ,
которое в десятичной форме как раз равно -27008
Именно поэтому компилятор “просил подтверждения” в форме явного приведения к конкретному типу. Во-первых, оно показывает, что ты берешь ответственность за результат на себя, а во-вторых, указывает компилятору сколько места выделить при приведении типов. Ведь если бы мы в последнем примере приводили
 Главное понимать принцип хранения значений
 Так вот.
Когда мы производим сложение

ПЕРЕЙДИТЕ В ПОЛНУЮ ВЕРСИЮ
0000 0000 = 0
0000 1001 = 9
0111 1111 = 127
Обрати внимание на старший бит. Он во всех положительных числах равен нулю. И, соответственно, для отрицательных чисел остаются только те, в которых этот старший бит равен 1. Не буду утомлять особенностями хранения таких значений, скажу лишь, что для того, чтобы изменить знак числа нужно проинвертировать все биты и прибавить 1. То есть:0000 1001 = 9 // инвертируем 1111 0110 = -10 // прибавим 1 1111 0111 = -9 // и повторим в обратном порядке, инвертируем снова 0000 1000 = 8 // прибавим 1 0000 1001 = 9Теперь можешь на бумаге ещё раз пересчитать и убедиться, что данное число при хранении в знаковом типе будет -27008, а вот если сделать через char, который не умеет хранить отрицательные числа, ты увидишь именно то, что насчитал на листе:System.out.println((short)10000000); // -27008 System.out.println((int)(char)10000000); // 385280000 00010000 0000 Остаётся: 0000 0000 Т.е. ноль. Можешь проверить всё это в редакторе кода. Это по вопросу отбрасывания левой части.intбудет 32768 без минуса. если преобразовать кshort10030000 то будет чуть меньше 3000 в общем.