Миллион выходных токенов GPT-5.5 через API стоит $30. У Claude Sonnet 5.5 — $10. У DeepSeek V4.1 Flash — от $0,60.
Это не опечатка. Разница — в десятки раз. А ещё модель DeepSeek можно скачать целиком и запустить на своём сервере, потому что её веса опубликованы под лицензией MIT. Хоть завтра встраивай в продукт.
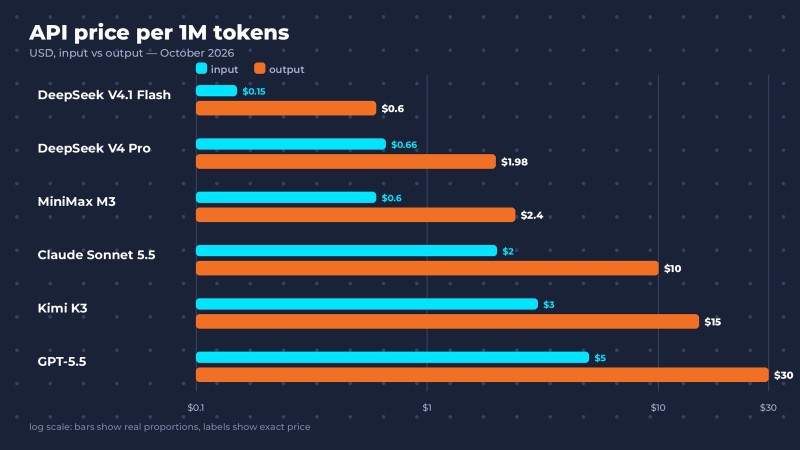
Звучит как развод из рекламы в соцсетях. Но это реальность 2026 года: китайские лаборатории выпускают модели уровня западных флагманов почти каждый месяц и раздают их бесплатно. Разработчики во всём мире этим уже пользуются.
Давай разберёмся, что это за модели, на что они реально способны, как подключить их к Claude Code — и где начинается подвох. Он есть, и не один.
Что такое открытые модели и почему это важно
Если совсем коротко: открытая модель (open-weight) — это нейросеть, чьи веса опубликованы для скачивания. Её можно запустить на своём железе, дообучить под свою задачу и встроить в продукт без подписки и без отправки данных в чужое облако.
ChatGPT и Claude — закрытые модели. Ты пользуешься ими только через сайт, приложение или API, а сама модель живёт на серверах OpenAI и Anthropic. Открытую модель можно получить в собственность: скачал — и она твоя, на твоих условиях. Насколько твоя — зависит от лицензии, но об этом ниже.
Почему китайцы раздают модели бесплатно
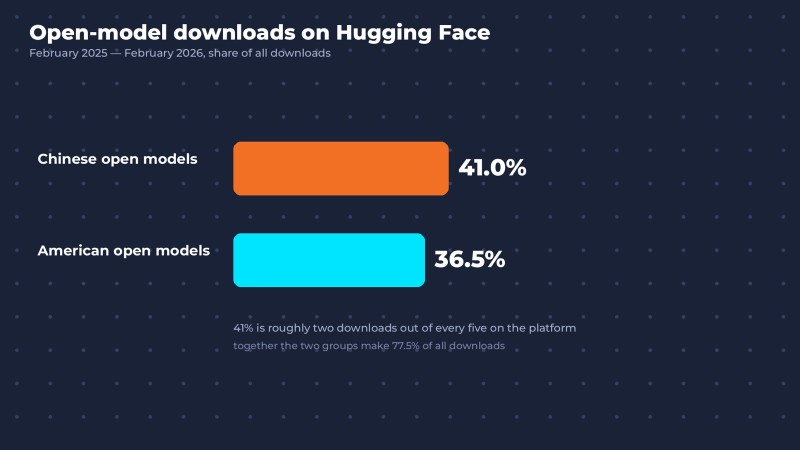
Ещё пару лет назад открытые модели ассоциировались в первую очередь с Llama от Meta. В 2026 году картина другая. По весеннему отчёту Hugging Face, с февраля 2025-го по февраль 2026-го на китайские открытые модели пришлось 41% всех скачиваний на платформе. На американские — 36,5%.
Семейство Qwen от Alibaba по разным оценкам перевалило за миллиард скачиваний и обогнало Llama. На его основе люди дообучили больше производных моделей, чем на основе любого другого семейства.
Почему китайские компании раздают то, за что OpenAI и Anthropic берут деньги? Причин несколько:
- Это стратегия захвата рынка. Когда разработчики по всему миру строят продукты на твоей модели, ты становишься стандартом. Деньги потом приходят от облака, корпоративных клиентов и следующих моделей.
- Конкуренция внутри Китая. DeepSeek, Alibaba, Moonshot, Zhipu, MiniMax и ByteDance соревнуются друг с другом так жёстко, что новая версия у кого-нибудь выходит почти каждую неделю.
- Цена обучения упала. Китайские лаборатории научились обучать сильные модели дешевле, в том числе в условиях ограничений на поставку американских чипов.
Для разработчика вывод простой: выбор моделей в 2026 году больше, чем когда-либо, и часть этого выбора бесплатна.
Главные китайские нейросети 2026 года
Сразу важная оговорка. Версии здесь меняются так быстро, что любой обзор устаревает за пару месяцев. Ниже — состояние на конец октября 2026 года.
DeepSeek V4: самый дешёвый API
Та самая компания, которая в январе 2025-го обрушила акции Nvidia. Сейчас у DeepSeek две основные модели: V4 Pro и V4.1 Flash. Последнюю версию Flash выложили 17 октября 2026 года, веса открыты под лицензией MIT, контекст — до миллиона токенов.
Сильная сторона — цена. Flash стоит в десятки раз дешевле западных флагманов, а в непиковые часы — ещё примерно вдвое дешевле. Для фоновой автоматизации, обработки документов и массовых задач это почти бесплатно.

Слабая сторона — надёжность в сложных агентных задачах. Tom's Hardware, разбирая новую модель, отдельно отметил: она экономно тратит память, но чаще проприетарных конкурентов галлюцинирует в агентных сценариях.
Qwen 3.8: самая популярная открытая модель
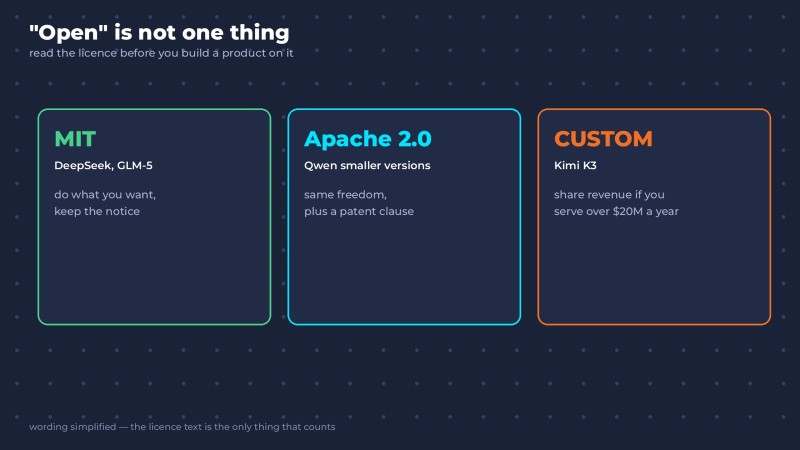
Семейство моделей от Alibaba. Актуальное поколение — Qwen 3.8, а Qwen 4, по словам Alibaba, сейчас в обучении. Главное достоинство Qwen — выбор размеров: от компактных моделей, которые реально запустить на своём компьютере, до тяжёлых флагманов. Младшие версии выходят под лицензией Apache 2.0, одной из самых свободных.
Если тебе нужна открытая модель, которую можно дообучить под свою задачу, Qwen — первый кандидат. Именно поэтому на его основе делают больше всего производных моделей.
Kimi K3: флагман для кода и агентов
Модель от Moonshot AI. K3 вышла 16 июля 2026 года, а через две недели Moonshot опубликовала её веса. Размер впечатляет: 2,8 триллиона параметров и контекст в миллион токенов. Модель заточена под длинные агентные задачи: навигацию по большим репозиториям, отладку, работу с инструментами и логами.
Kimi мы уже встречали в новостях: недавно он откопал RCE-уязвимость в Redis за 27 минут.
Нюанс — лицензия. Она не MIT, а собственная: провайдеры, которые зарабатывают на инференсе K3 больше $20 млн в год, должны делиться выручкой. Для тебя как разработчика это вряд ли станет проблемой, но читать лицензию перед использованием в продукте стоит всегда.
GLM-5: открытая модель для кодинга
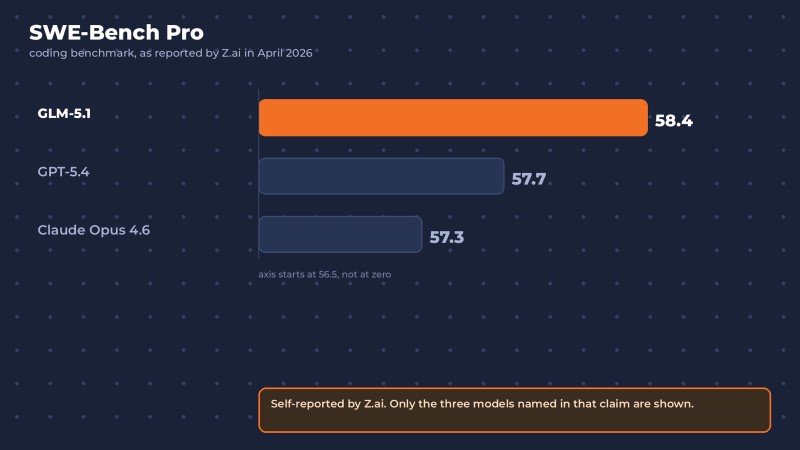
Линейка от Z.ai, бывшей Zhipu AI. В апреле 2026 года компания открыла веса GLM-5.1 под лицензией MIT, и по собственным замерам Z.ai модель вышла на первое место в бенчмарке SWE-Bench Pro, опередив GPT-5.4 и Claude Opus 4.6. Оговорка: результат заявлен самой компанией, а с тех пор Z.ai выпустила ещё несколько версий — релизы здесь идут почти ежемесячно.
Для разработчиков у Z.ai есть отдельный GLM Coding Plan — подписка от $18 в месяц, которая работает прямо внутри Claude Code. Про это ниже.
MiniMax M3: миллион токенов и мультимодальность
Модель от MiniMax, вышедшая летом 2026 года с открытыми весами. Компания делает ставку на сочетание трёх вещей в одной модели: сильного кодинга, контекста в миллион токенов и нативной работы с картинками. Хороший вариант, когда нужно скормить модели большой объём документации или кода целиком.
Seedream и Seedance: картинки и видео от ByteDance
Китайские компании сильны не только в текстовых моделях. ByteDance — та, что сделала TikTok, — выпускает генераторы картинок и видео, которые соревнуются с лучшими западными.
Seedream 5.0 — генератор изображений. ByteDance выпустила его в феврале 2026 года как более дешёвую альтернативу Nano Banana Pro от Google, а летом добавила версию Pro. Модель выдаёт картинки в 2K и 4K, умеет редактировать изображения по референсам и в облегчённой версии даже ищет информацию в интернете перед генерацией. Через OpenRouter одна картинка Seedream 5.0 Pro стоит около $0,045.
Seedance 2.0 — генератор видео. С весны 2026 года он встроен прямо в CapCut и Dreamina, а на Dreamina уже появилась версия 2.5, которая генерирует ролики до 30 секунд. Для разработчика есть API через BytePlus.
Зачем это разработчику? Затем, что продукт — это не только код. Иконки, иллюстрации для лендинга, ассеты для игры, демо-ролик для запуска — раньше на всё это нужен был дизайнер, видеомонтажёр и бюджет. Сейчас первую версию можно собрать за вечер. Один человек с кодом и такими инструментами выпускает то, что раньше требовало маленькой команды.
Сравнение: какую модель выбрать
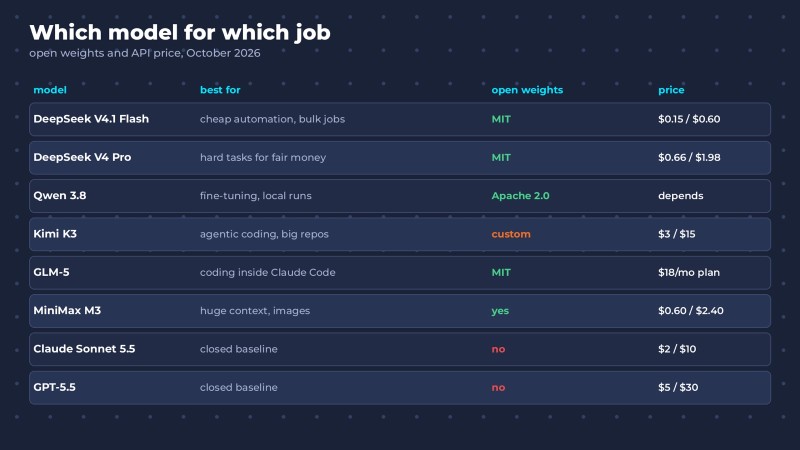
| Модель | Для чего лучше всего | Открытые веса | Цена API (за 1 млн токенов, вход / выход) |
| DeepSeek V4.1 Flash | Дешёвая автоматизация, массовые задачи | Да, MIT | от $0,15 / $0,60 |
| DeepSeek V4 Pro | Сложные задачи за умеренные деньги | Да, MIT | около $0,66 / $1,98 |
| Qwen 3.8 | Дообучение, локальный запуск, выбор размеров | Да, младшие версии — Apache 2.0 | зависит от размера и провайдера |
| Kimi K3 | Агентный кодинг, большие репозитории | Да, собственная лицензия | $3 / $15 |
| GLM-5 | Кодинг, работа в Claude Code | Да, MIT | Coding Plan от $18 в месяц |
| MiniMax M3 | Огромный контекст, картинки + код | Да | около $0,60 / $2,40 |
| Для сравнения: Claude Sonnet 5.5 | — | Нет | $2 / $10 |
| Для сравнения: GPT-5.5 | — | Нет | $5 / $30 |
Цены у китайских провайдеров меняются часто, бывают скидки на запуск и разные тарифы для пикового и ночного времени. Перед тем как закладывать стоимость в продукт, сверяйся с официальной страницей цен.
Как подключить китайскую модель к Claude Code
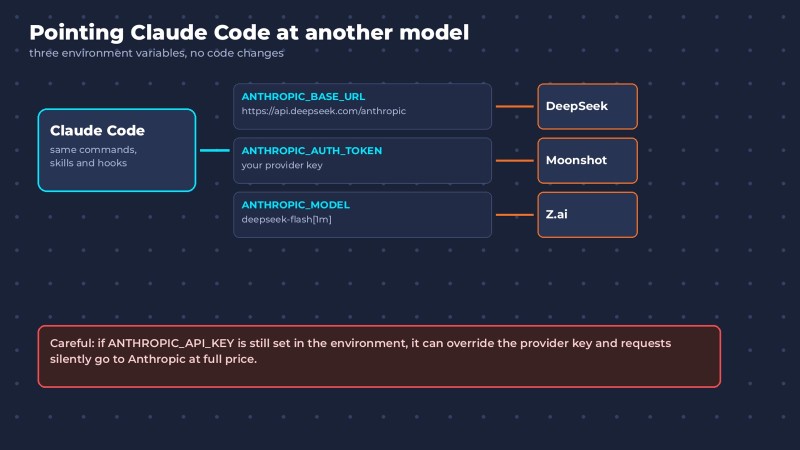
А теперь самое практичное. Claude Code умеет работать не только с моделями Claude. Он отправляет запросы на адрес из переменной окружения ANTHROPIC_BASE_URL, а DeepSeek, Moonshot и Z.ai сделали у себя API, совместимые с форматом Anthropic.
Вот официальная настройка из документации DeepSeek:
export ANTHROPIC_BASE_URL=https://api.deepseek.com/anthropic
export ANTHROPIC_AUTH_TOKEN=<твой ключ DeepSeek API>
export ANTHROPIC_MODEL=deepseek-flash[1m]
export ANTHROPIC_DEFAULT_OPUS_MODEL=deepseek-flash[1m]
export ANTHROPIC_DEFAULT_SONNET_MODEL=deepseek-flash[1m]
export ANTHROPIC_DEFAULT_HAIKU_MODEL=deepseek-flash
export CLAUDE_CODE_SUBAGENT_MODEL=deepseek-flash
claude
Суффикс [1m] включает контекст в миллион токенов. Если в настройках оставить имена моделей Claude, DeepSeek сам перенаправит запросы: Opus — на V4 Pro, Sonnet и Haiku — на Flash.
После этого Claude Code работает как обычно — те же команды, те же скиллы, те же субагенты, — но думает за него DeepSeek. У Moonshot для Kimi K3 и у Z.ai для GLM схема та же: свой адрес API и свой ключ.
Три вещи, которые стоит знать заранее:
- Это не официально поддерживаемая Anthropic конфигурация. Её документируют сами китайские провайдеры. Что-то может работать иначе: например, в меню
/modelкитайские модели не появятся, а проверить, какая модель сейчас отвечает, можно через/status. - Следи за переменной
ANTHROPIC_API_KEY. Если она осталась в окружении, она может перебить ключ провайдера, и запросы молча уйдут в Anthropic по полной цене. - Качество будет другим. Claude Code настроен под модели Claude. На простых задачах разница почти незаметна, на длинных агентных сессиях — заметна.
Как устроены сам агент, скиллы, субагенты и хуки, мы подробно разбирали в статье «Как устроен ИИ-агент».
Где подвох
Восторженные обзоры обычно на этом заканчиваются. Мы — нет. Вот четыре вещи, которые стоит понимать до того, как переводить работу на китайскую модель.
1. «Запустить у себя» — это не про ноутбук
Обзоры любят писать, что китайские модели можно запустить через Ollama или LM Studio прямо на своём компьютере. Технически — да. Практически — только маленькие версии. Флагман GLM-5.1 весит около 744 миллиардов параметров, Kimi K3 — 2,8 триллиона. Чтобы запустить такое, нужен не ноутбук, а серверная стойка с несколькими дорогими видеокартами.
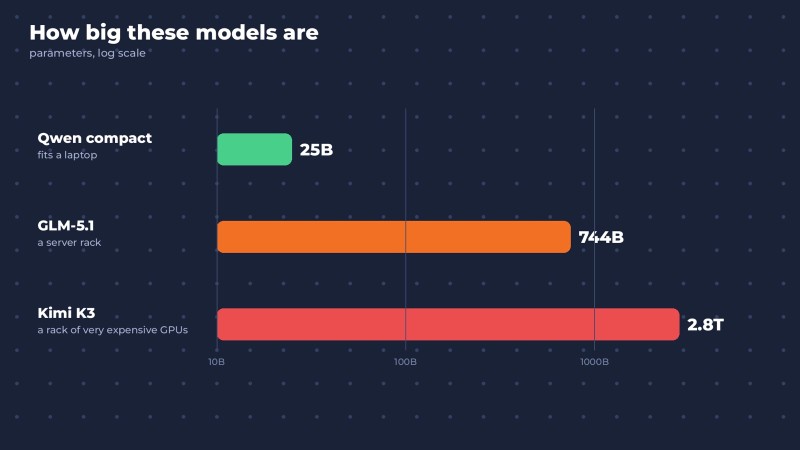
На обычном компьютере реально работают компактные дистиллированные модели — например, младшие версии Qwen на 20–30 миллиардов параметров. Они полезны, но до флагманов не дотягивают.
2. Куда уходят твои данные
Открытая модель на своём сервере — это одно. Облачный API китайской компании — совсем другое. Политика конфиденциальности DeepSeek прямо говорит, что запросы и загруженные файлы хранятся на серверах в Китае. Именно поэтому Австралия запретила DeepSeek на государственных устройствах, регулятор Италии потребовал убрать приложение из магазинов, а Чехия и Тайвань запретили его в госструктурах.
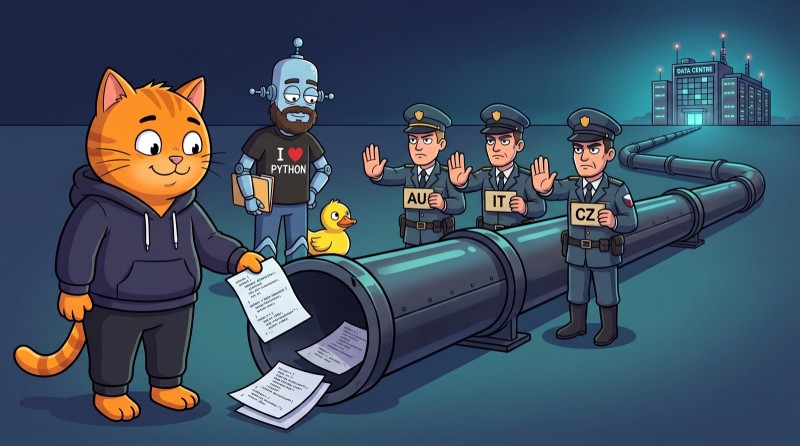
Практическое правило: личный пет-проект через китайский API — пожалуйста. Рабочий код компании, ключи, данные клиентов — только через локальный запуск или через западного провайдера, который хостит открытые веса у себя. Веса одни и те же, а данные остаются под твоим контролем.
3. Нейрослоп никто не отменял
Дешёвая модель ошибается не реже дорогой, а иногда и чаще. На сложной логике и длинных агентных задачах китайские модели заметно чаще уверенно выдают неработающий код или придумывают несуществующие методы. Бенчмарки, которые публикуют сами компании, стоит делить на два: они измеряют то, что удобно измерять.
4. «Открытая» не значит «делай что хочешь»
MIT и Apache 2.0 — действительно свободные лицензии. А вот у Kimi K3 лицензия собственная, с условиями для крупных коммерческих провайдеров. Перед тем как строить на модели продукт, потрать десять минут и прочитай лицензию. Это дешевле, чем потом переделывать архитектуру.
Что это значит для разработчика
Есть старая мысль, которую мы повторяем уже много лет: инструменты обнуляются, фундамент остаётся. Китайские модели показывают это нагляднее всего.
Ещё год назад доступ к сильной модели был преимуществом. Сейчас модель уровня флагмана можно получить бесплатно, а через месяц выйдет следующая — и тоже бесплатно. Модели становятся сырьём, как электричество. Никто не гордится тем, что у него в розетке есть ток.
Ценность смещается к тому, кто умеет этим током пользоваться. Выбрать модель под задачу и бюджет. Подключить её к агенту. Проверить, что она написала, — и заметить, где она уверенно ошиблась. Настроить права так, чтобы агент не натворил дел. Это и есть навык, за который платят. И он не обесценивается с выходом следующей модели — наоборот, дорожает.

Лучшая модель — не та, что выше в бенчмарке, а та, результат которой ты умеешь проверить.
Где этому научиться
Работать с агентами так, чтобы не зависеть от одной конкретной модели, — ровно то, чему посвящён наш курс по Claude Code от AI Academy. 16 уровней и 200+ задач: права и контекст, скиллы, субагенты, MCP, хуки, plan mode и контроль через git. Всё это работает одинаково, какая бы модель ни стояла под капотом.
А если хочется перестроить на агентах всю работу и разобраться системно, с ментором и проектами, для этого есть AI Native Developer в JavaRush University.
Частые вопросы
Какие китайские нейросети лучшие в 2026 году? На конец октября 2026 года основные — DeepSeek V4 (самый дешёвый API), Qwen 3.8 от Alibaba (самая популярная открытая модель), Kimi K3 от Moonshot AI (агентный кодинг и большие репозитории), линейка GLM-5 от Z.ai (кодинг, работа в Claude Code) и MiniMax M3 (контекст в миллион токенов и мультимодальность). Для картинок и видео — Seedream 5.0 и Seedance 2.0 от ByteDance.
Могут ли китайские нейросети заменить ChatGPT и Claude? Для многих задач — да: автоматизация, обработка документов, генерация кода средней сложности. На сложной логике и длинных агентных сценариях китайские модели пока чаще ошибаются. Главные плюсы — цена API в десятки раз ниже и возможность запустить модель на своём сервере.
Сколько стоит API китайских нейросетей? DeepSeek V4.1 Flash стоит от $0,15 за миллион входных и $0,60 за миллион выходных токенов. Kimi K3 — $3 и $15. Для сравнения: Claude Sonnet 5.5 — $2 и $10, GPT-5.5 — $5 и $30. Цены часто меняются, поэтому сверяйся с официальными страницами провайдеров.
Можно ли запустить китайскую нейросеть на своём компьютере? Только компактные версии — например, младшие модели Qwen на 20–30 миллиардов параметров через Ollama или LM Studio. Флагманы вроде GLM-5.1 (около 744 миллиардов параметров) или Kimi K3 (2,8 триллиона) требуют серверного железа с несколькими мощными видеокартами.
Безопасно ли отправлять код в китайские нейросети? Через облачный API — с осторожностью: например, DeepSeek хранит запросы и файлы на серверах в Китае, поэтому ряд стран запретил его на государственных устройствах. Для рабочего кода и данных клиентов надёжнее запускать открытые веса локально или через западного провайдера, который хостит их у себя.
Как подключить DeepSeek или Kimi к Claude Code? Через переменные окружения: задать ANTHROPIC_BASE_URL на Anthropic-совместимый адрес провайдера (например, https://api.deepseek.com/anthropic), ключ провайдера в ANTHROPIC_AUTH_TOKEN и имя модели в ANTHROPIC_MODEL. Это задокументированная провайдерами, но не официально поддерживаемая Anthropic конфигурация.
ПЕРЕЙДИТЕ В ПОЛНУЮ ВЕРСИЮ